Broadcom, AI망을 세 겹으로 잇는다…OCP서 102.4T CPO 공개
Broadcom이 10월 12~15일 열리는 OCP Global Summit 2026에서 AI 클러스터의 스케일업·스케일아웃·스케일어크로스 연결을 한 포트폴리오로 제시합니다. Tomahawk 6·Ultra와 Jericho 4 스위치, Thor 800G·400G NIC, 102.4Tbps급 TH6-Davisson 3세대 공동 패키지 광학을 ORV3 랙에 묶습니다. 10만개가 넘는 가속기 규모를 겨냥하지만 실제 효율과 상호운용성은 파트너 데모 이후 확인해야 합니다.
AI 클러스터를 세 층의 네트워크로 본다
Broadcom은 10월 8일 OCP Global Summit 2026 참가 계획을 공개하며 AI 데이터센터의 연결을 스케일업, 스케일아웃, 스케일어크로스라는 세 층으로 정리했습니다. 한 랙이나 가속기 도메인 안에서 대역폭을 모으고, 여러 랙을 학습 패브릭으로 확장한 뒤, 떨어진 클러스터와 데이터센터까지 잇는 구상입니다. 거대 모델이 커질수록 계산칩 수보다 칩 사이 통신과 전력 비용이 먼저 병목이 된다는 판단이 배경입니다.
회사는 10월 12일부터 15일까지 미국 새너제이에서 열리는 행사에서 Open Rack Version 3 기반 시스템을 전시합니다. 기조연설에서는 개방형 네트워킹과 광 인터커넥트, 모듈형 랙을 조합해 10만개가 넘는 가속기를 연결하는 설계를 다룰 예정입니다. 특정 서버 한 대의 성능이 아니라 전체 클러스터가 얼마나 효율적으로 하나의 컴퓨터처럼 움직이는지를 경쟁 축으로 세운 셈입니다.
스위치·NIC·광학을 하나의 포트폴리오로
핵심 부품은 Tomahawk 6, Tomahawk Ultra와 Jericho 4 이더넷 스위치, Thor Ultra 800G와 Thor 2 400G AI 이더넷 NIC입니다. Tomahawk 6는 고밀도 스케일아웃 패브릭, Tomahawk Ultra는 가속기 사이의 짧고 빠른 스케일업 연결, Jericho 4는 더 넓은 영역과 깊은 버퍼가 필요한 분산 연결에 각각 무게를 둡니다. NIC까지 같은 생태계로 제시해 서버 끝단과 패브릭 제어를 함께 최적화하려는 전략입니다.
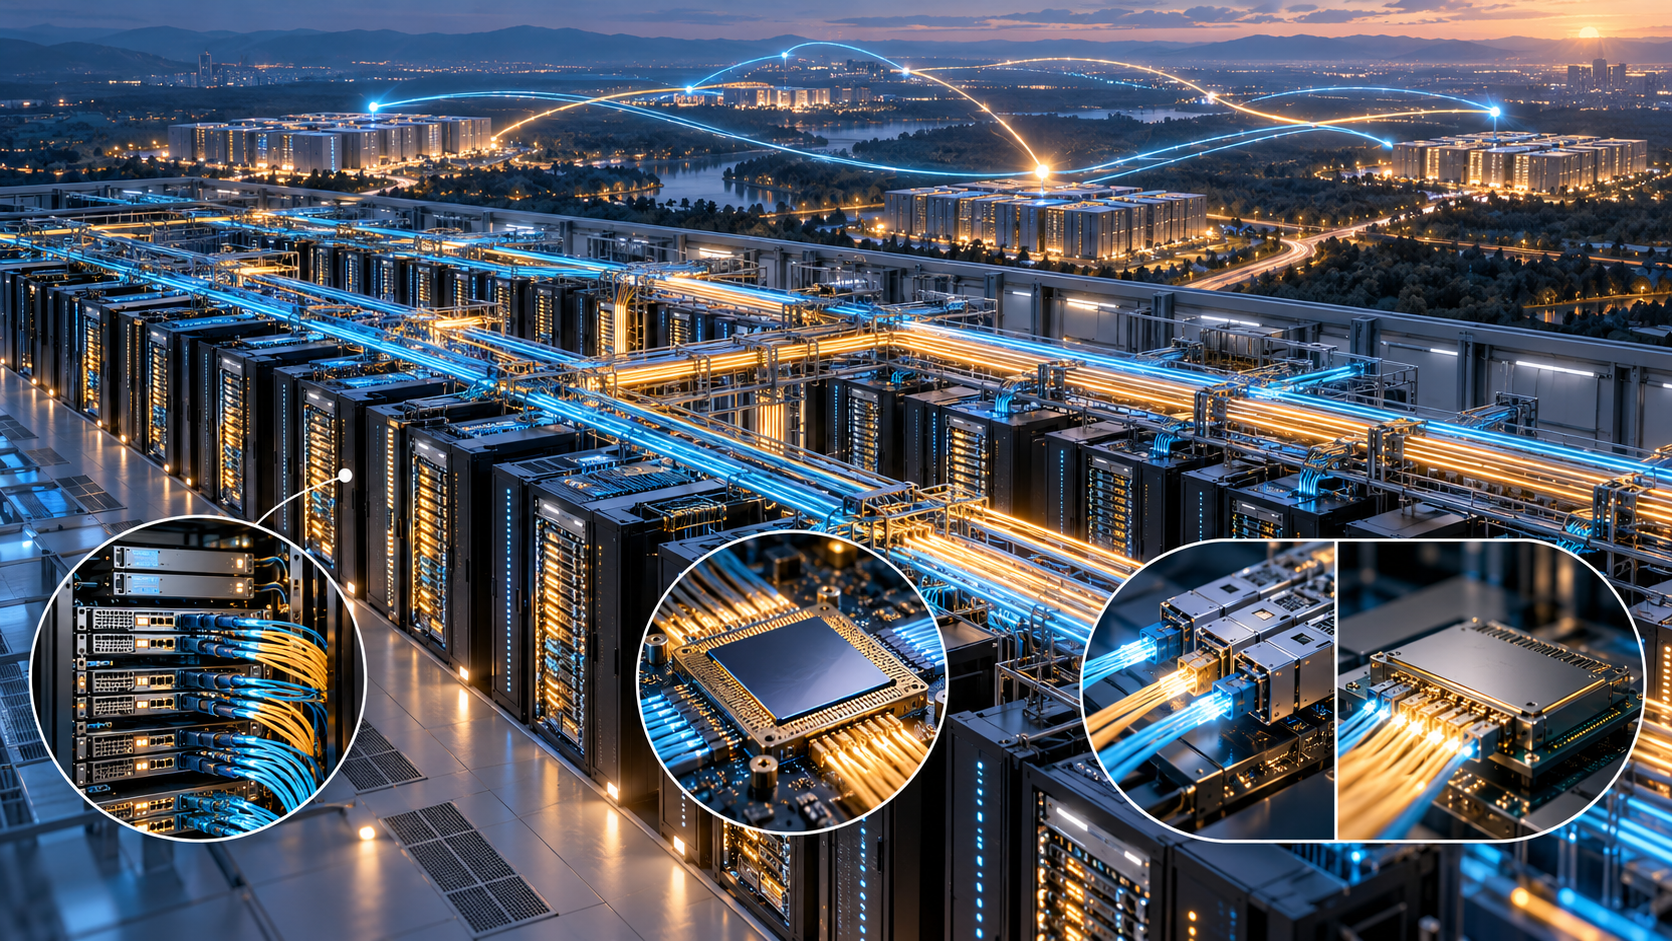
여기에 3세대 TH6-Davisson 공동 패키지 광학, 즉 CPO가 들어갑니다. 102.4Tbps급 Tomahawk 6 스위치 실리콘 가까이에 광학 엔진을 배치해 보드 위 전기 신호가 이동하는 거리를 줄입니다. 전송 속도가 높아질수록 구리 배선의 손실과 냉각 부담이 커지므로, 광학을 스위치에 가깝게 붙이는 설계는 대역폭당 전력과 포트 밀도를 개선할 후보입니다.
15곳이 넘는 파트너가 랙에서 검증
이번 발표는 칩 목록만이 아니라 장비 생태계 전시 계획을 강조합니다. Accton·Edgecore는 Tomahawk 6, Alpha Networks는 액체냉각 Tomahawk 6 시스템을 선보입니다. Celestica, Delta Electronics와 Micas Networks는 102.4T TH6-Davisson CPO 장비를 전시합니다. Broadcom은 전체 행사장에서 15곳이 넘는 파트너와 공동 데모를 진행한다고 밝혔습니다.
세션도 224G 액티브 전기 케이블, 광 AI 패브릭, 다중경로 신뢰 연결 MRC, SRv6, 스케일업용 이더넷 전송 SUE-T와 정밀 시각 동기화까지 넓게 배치됐습니다. OpenAI와 Celestica, Arista, Microsoft, Nokia 관계자들이 공동 발표에 참여합니다. 개방형 규격이 실제 운영 장비와 연결되는지를 칩 공급자 혼자 설명하지 않고 서버·스위치·클라우드 파트너가 함께 보여 주려는 방식입니다.
이더넷이 전용 연결과 겨루는 지점
AI 스케일업은 손실 없는 전송, 짧은 지연과 빠른 혼잡 제어가 필요해 전용 인터커넥트가 강한 영역입니다. Broadcom은 이더넷을 랙 내부까지 끌어들이면 표준 기반 장비 선택권과 대규모 운영 경험을 유지하면서 스케일업과 스케일아웃을 한 관리 체계로 묶을 수 있다고 주장합니다. 스케일어크로스까지 같은 계열 기술을 쓰면 학습과 추론 자원을 지역 사이에 더 유연하게 배치할 여지도 생깁니다.
반대로 제품 이름이 같다고 세 층의 요구가 자동으로 통합되는 것은 아닙니다. 랙 내부의 마이크로초 단위 지연, 데이터센터 패브릭의 혼잡, 장거리 연결의 장애와 비용은 서로 다릅니다. 실제 경쟁력은 표준 준수뿐 아니라 집단 통신 성능, 장애 때의 재수렴, 텔레메트리와 소프트웨어 운영성이 얼마나 함께 작동하는지에 달려 있습니다.
현장에서 확인해야 할 숫자
공식 자료는 102.4Tbps CPO와 800G·400G NIC, 10만개 이상 가속기라는 규모를 제시하지만 이번 발표문 자체에는 동일 조건의 전력 절감률이나 애플리케이션 지연 비교가 없습니다. CPO는 효율을 높일 잠재력이 큰 대신 광 엔진 교체와 수리, 열관리와 공급망 같은 새로운 운영 과제를 만듭니다. 장비별 상호운용성도 공동 데모 이후의 시험 결과가 필요합니다.
따라서 이번 OCP 발표의 의미는 단일 신제품보다 로드맵의 결합에 있습니다. 스위치 ASIC, NIC, 구리와 광 연결, 개방형 랙을 한 설계 언어로 묶어 AI 인프라 병목을 공략합니다. 현장에서 볼 기준은 대역폭만이 아닙니다. 같은 작업을 처리할 때의 전력, 포트 장애 뒤 복구 시간, 다른 업체 장비와의 연결, 광 모듈의 유지보수성이 공개되는지까지 확인해야 ‘개방형 AI 네트워크’라는 약속의 실체를 판단할 수 있습니다.
기사가 마음에 드셨다면 하트를 눌러주세요.
기사 읽고, 잠깐 게임 한 판 어떠세요?
전국을 여행하며 지역과 특산물을 만나는 한글 타자게임
미니게임 고르기 ▶