SK하이닉스, HBM5·CoWoS 검증…AI 메모리를 ‘GPU 옆 칩’에서 전체 시스템으로
SK하이닉스가 TSMC OIP 콘퍼런스에서 NVIDIA Vera Rubin용 HBM4·SOCAMM2부터 서버 DRAM, 액체냉각 eSSD까지 AI 메모리 포트폴리오를 공개했습니다. 차세대 HBM5를 TSMC CoWoS 기반으로 공동 검증한 성과로 2년 연속 파트너상을 받았고, PCIe 6·7세대 SSD에는 UCIe 칩렛 구조를 준비합니다. 발표는 AI 병목이 연산칩 하나가 아니라 메모리·패키징·저장장치의 공동 설계 문제로 이동했음을 보여 줍니다.
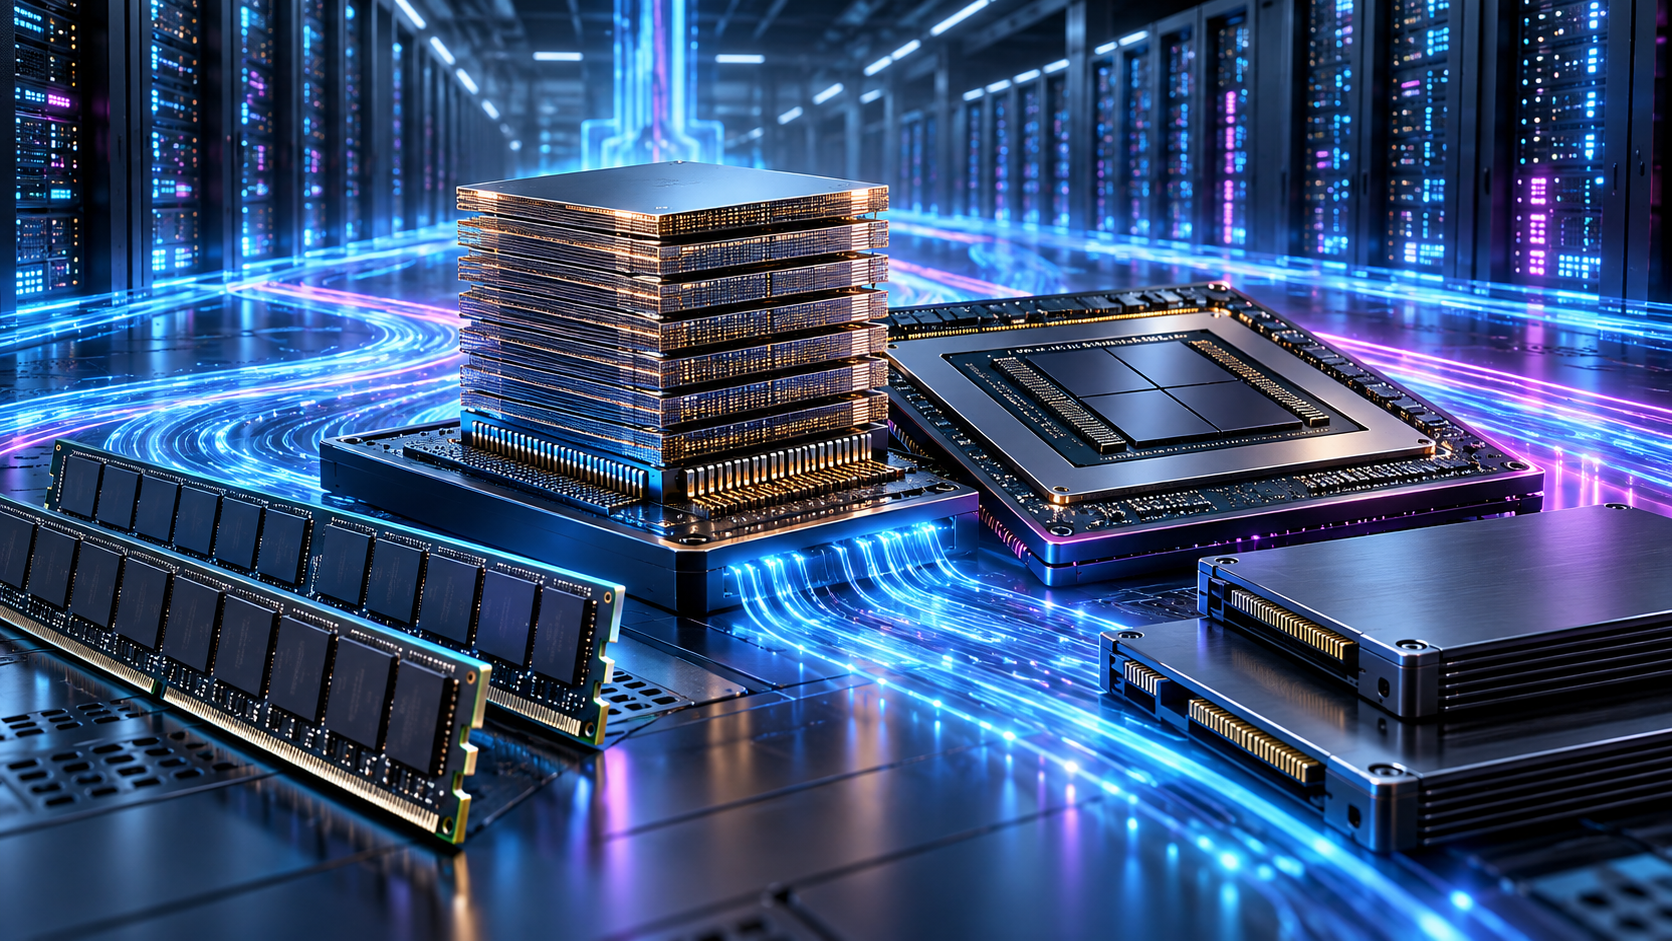
AI 메모리 전시가 ‘한 대의 시스템’이 됐다
SK하이닉스는 9월 23일 미국 산타클라라에서 열린 TSMC Open Innovation Platform 콘퍼런스의 내용을 28일 공개했습니다. 전시 중심에는 NVIDIA 차세대 슈퍼칩 Vera Rubin과 그 주변의 36GB 12단 HBM4, 96GB SOCAMM2가 놓였습니다. HBM이 GPU 근처에서 행렬연산 데이터를 빠르게 공급하고, 저전력 DRAM 기반 SOCAMM2가 Vera CPU의 긴 문맥과 시스템 작업을 받치는 구성을 한눈에 보여 준 것입니다.
이번 발표의 메시지는 ‘더 빠른 HBM 한 종류’보다 넓습니다. 모델의 가중치와 KV 캐시, 학습 체크포인트와 데이터셋은 서로 다른 용량·속도·전력 요구를 가집니다. 그래서 HBM, 서버 DRAM, SSD를 별개 카탈로그가 아니라 하나의 데이터 이동 계층으로 설계해야 GPU가 기다리는 시간을 줄일 수 있습니다.
HBM4에서 HBM5까지, 패키징과 함께 검증
전시장에는 Vera Rubin 탑재품 외에도 48GB 12단 HBM4E, 48GB 16단 HBM4, 36GB 12단 HBM3E와 192GB SOCAMM2가 나란히 놓였습니다. 적층 수와 용량이 늘어날수록 열, 전력, 신호 무결성과 수율 문제가 함께 커지므로 제품 이름만 바꾸는 방식으로는 다음 세대를 만들기 어렵습니다.
SK하이닉스는 TSMC의 2.5D 첨단 패키징 CoWoS를 바탕으로 HBM5를 초기 단계부터 공동 검증한 성과를 인정받아 3DFabric-HBM Integration 부문 Partner of the Year를 2년 연속 수상했습니다. 메모리와 로직, 인터포저를 실제 가속기 조건에서 함께 맞추는 ‘공동 설계’가 세대 전환의 핵심 공정이 됐다는 의미입니다.
서버 DRAM과 냉각형 SSD까지 병목을 옮겨 본다
서버 DRAM에서는 256GB 3DS RDIMM, 두 랭크를 동시에 동작시키는 128GB MRDIMM, 1c 공정을 적용한 64GB RDIMM을 공개했습니다. AI 서버가 더 많은 모델과 에이전트를 동시에 운영하면 GPU 바깥의 시스템 메모리 용량과 대역폭도 처리량을 결정합니다. SOCAMM2와 RDIMM은 서로 다른 서버 구조와 전력 예산을 겨냥합니다.
저장장치에는 직접 액체냉각을 지원하는 PEB210 E1.S와 QLC NAND 기반 PS1101 E3.S가 포함됐습니다. 같은 면적에 더 많은 데이터를 담는 QLC는 대규모 AI 데이터 저장 비용을 낮출 수 있지만 지연시간·내구성·쓰기 성능을 워크로드에 맞춰 검증해야 합니다. 액체냉각 지원은 고밀도 랙에서 저장장치도 열 설계의 일부가 됐음을 보여 줍니다.
PCIe 6·7세대 SSD도 칩렛으로
SK하이닉스는 PCIe 기반 eSSD 시장이 2026년 509EB에서 2030년 1,933EB로 약 3.8배 성장할 것이라는 자체 전망을 제시했습니다. 이를 겨냥해 PCIe 6·7세대 SSD 컨트롤러를 하나의 큰 칩 대신 기능별 칩렛으로 나누고 UCIe로 연결하는 구조를 준비합니다.
칩렛은 각 기능의 세대 전환을 독립적으로 진행하고 필요한 용량만 확장하며 전력을 조정할 수 있다는 장점이 있습니다. 다만 인터페이스 지연, 패키징 비용과 소프트웨어 검증이 새 복잡성으로 들어옵니다. 시장 전망과 개발 로드맵은 회사 발표이므로 실제 출하 시점, 고객 인증과 총소유비용을 따로 확인해야 합니다.
경쟁 기준은 최고 사양보다 계층 간 균형
이번 포트폴리오는 HBM만 빠르면 AI 서버가 빨라진다는 단순한 서사를 벗어납니다. 가속기 가까이에는 HBM, CPU에는 SOCAMM2, 일반 서버 작업에는 RDIMM, 대규모 데이터에는 eSSD를 배치하고 이들을 패키징과 PCIe로 연결해야 실제 처리량이 나옵니다. 병목이 한 계층에서 풀리면 곧 다음 계층으로 이동하기 때문입니다.
따라서 구매자와 개발자가 볼 지표도 제품별 대역폭을 넘어야 합니다. 실제 모델에서의 토큰 처리량, 랙당 전력과 냉각비, 장애 복구, 장시간 쓰기 내구성, 공급 안정성과 패키징 수율을 함께 비교해야 합니다. SK하이닉스의 발표는 완성된 우위를 증명한 결과라기보다 메모리 기업의 경쟁장이 전체 AI 시스템 설계로 넓어졌다는 신호입니다.
기사가 마음에 드셨다면 하트를 눌러주세요.
기사 읽고, 잠깐 게임 한 판 어떠세요?
입체적인 캐릭터 체스 말로 즐기는 AI 대국
미니게임 고르기 ▶