Jev, 문장 대신 ‘결정’을 반환한다…34만6천건 평가가 드러낸 장점과 한계
TypeSafe AI의 ‘Jev’는 답변 문장을 생성하지 않고, 미리 정한 선택지·등급·참일 확률만 반환하는 ‘System One’ 모델입니다. 독립 연구진은 37개 데이터셋에서 34만6,009건을 10달러 미만으로 평가해 다수 과제에서 비교 모델보다 높은 성능을 확인했습니다. 다만 이진 확률은 0.5 문턱에 그대로 적용하면 성능이 크게 떨어졌고 저자원 언어·모호한 평가 기준에서도 약했습니다. ‘형식 오류가 없다’는 장점과 ‘결정이 옳다’는 주장을 구분해야 합니다.
대화형 AI와 다른 ‘결정 함수’
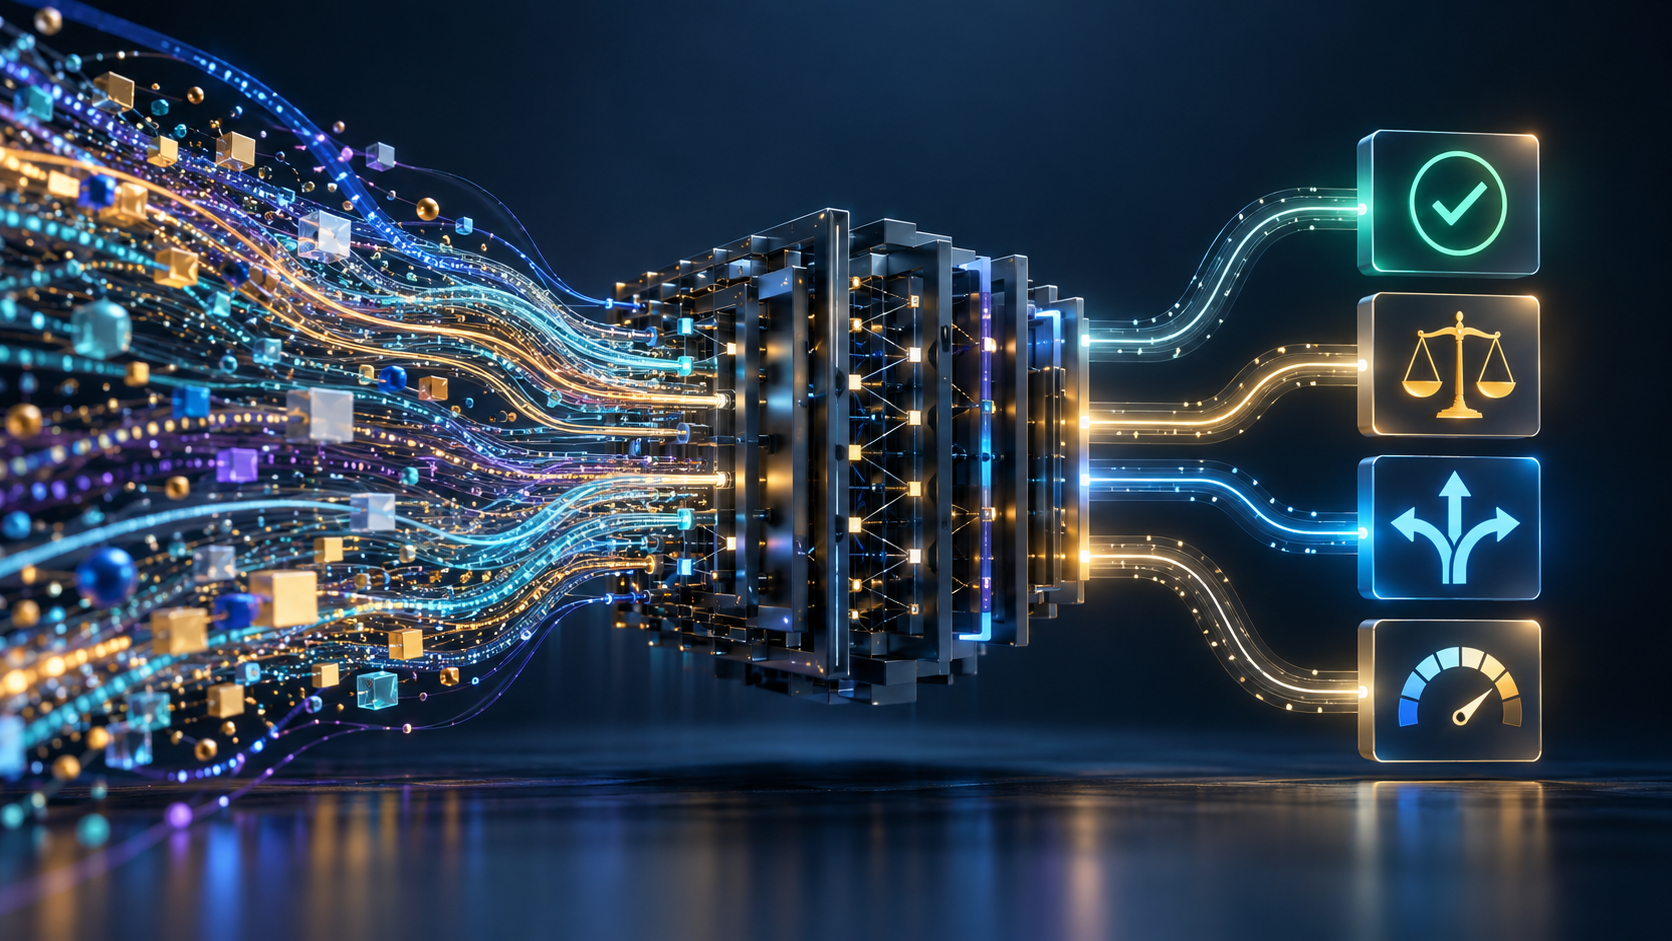
TypeSafe AI가 9월 15일 얼리 액세스로 공개한 Jev는 질문에 문장을 써 주는 대형언어모델과 출발점이 다릅니다. 개발자가 가능한 출력의 형태와 선택지를 먼저 정하면, 모델은 비정형 상태 정보를 읽고 하나의 선택, 평가 등급 또는 명제가 참일 확률을 반환합니다. 모든 결과에는 신뢰도와 확률이 붙고, 출력은 프로그램이 곧바로 처리할 수 있는 타입으로 제한됩니다.
회사는 이를 ‘System One’ 모델이라 부르며 분류·라우팅·점수화·추출·분기 같은 반복 결정을 겨냥합니다. 토큰을 한 글자씩 생성하지 않고 필요한 출력을 병렬로 계산한다는 설명입니다. TypeSafe는 입력 100만 토큰당 0.042달러, 출력 비용 없음, 70~500밀리초 응답을 제시하지만 이는 현재 서비스 환경에서 측정한 회사 수치입니다. 장기 가격과 부하별 속도는 더 지켜봐야 합니다.
34만6천건을 10달러 미만으로 돌린 평가
9월 29일 공개된 독립 프리프린트는 Jev 1.13.0을 37개 데이터셋에 제로샷으로 적용했습니다. 감성 분류, 자연어 추론, 독해, 상식 추론, 콘텐츠 조정, 법률 조항 분석과 평가 루브릭을 아우른 34만6,009건의 요청을 동일한 템플릿으로 실행했습니다. 비교 대상은 Qwen3.8-27B와 Gemma-4-E4B였고, 코드·평가 도구·원시 응답도 공개했습니다.
Jev는 IMDB·SST-2·HellaSwag·ARC에서 95~99% 정확도, 122개 언어의 Belebele에서 86.7%를 기록했습니다. 연구진의 설정에서는 Qwen보다 37개 중 27개, Gemma보다 37개 모두에서 앞섰습니다. 그러나 이는 세 모델의 특정 버전과 제로샷 설정을 비교한 결과이며 모든 생성형 모델이나 실제 업무 전반의 우위를 뜻하지 않습니다. 논문도 아직 동료평가 전입니다.
‘확률을 준다’와 ‘바로 믿는다’는 다르다
가장 중요한 한계는 이진 확률의 문턱이었습니다. Jev가 내놓은 확률은 정답 순서를 가르는 데는 유용했지만 고정 0.5를 기준으로 자동 판정하면 위치가 어긋났습니다. UNFAIR-ToS 과제에서 학습 데이터로 임계값을 조정하자 micro-F1이 0.50에서 0.75로 올랐습니다. 모델을 연결했다고 즉시 운영 규칙이 완성되는 것이 아니라 업무별 보정이 필요하다는 의미입니다.
세 모델 모두 저자원 언어, 세밀하거나 잡음이 섞인 라벨, 주관적 루브릭 평가에서 성능이 떨어졌습니다. 선택지 순서를 돌려도 Jev 정확도는 유지됐고 질문을 숨기면 우연 수준으로 내려가 단순 위치 암기는 배제됐지만, 학습 중 동일 문답을 기억했을 가능성까지 없앤 것은 아닙니다. 비용이 싸더라도 검증용 표본과 오류 분석 예산은 남겨야 합니다.
‘환각이 없다’는 표현의 정확한 범위
TypeSafe는 Jev가 문자열 생성을 포기해 ‘환각할 수 없다’고 표현합니다. 엄밀히는 정의되지 않은 필드나 엉뚱한 문장을 반환하는 타입 오류를 구조적으로 막는다는 뜻에 가깝습니다. 예를 들어 결제 심사 모델이 허용·검토·거절 세 값 중 하나만 내놓도록 보장할 수 있습니다. 프로그램이 파싱에 실패하거나 새로운 도구 이름을 꾸며 내는 위험은 크게 줄어듭니다.
하지만 허용을 골라야 할 사례에서 거절을 선택하는 판단 오류는 여전히 가능합니다. 잘못된 입력, 편향된 라벨, 바뀐 정책과 분포 이동도 타입 검사로 잡히지 않습니다. 따라서 ‘유효한 형식’과 ‘올바르고 공정한 결정’을 구분해야 합니다. 실제 자동화에는 임계값 보정, 보류 구간, 사람에게 넘기는 규칙과 사후 감사가 함께 필요합니다.
생성보다 좁은 모델이 넓히는 자동화
Jev가 흥미로운 이유는 모든 일을 한 모델에 맡기는 흐름과 반대이기 때문입니다. 고객 문의를 어느 팀으로 보낼지, 검색 결과가 근거를 갖췄는지, 거래를 추가 검토할지처럼 선택지가 명확한 구간에서는 자유로운 문장보다 제한된 결정 인터페이스가 소프트웨어에 연결하기 쉽습니다. 실시간 대량 처리에서 비용과 지연시간이 중요한 서비스에도 맞습니다.
도입 여부를 판단할 때는 평균 정확도보다 업무별 오탐·누락 비용, 확률 보정, 언어·집단별 격차와 분포 변화 감지를 봐야 합니다. 이번 평가가 보여 준 것은 ‘작은 결정 전용 모델’이 실험할 가치가 있다는 점이지 범용 LLM의 종말이 아닙니다. 생성 모델이 후보를 만들고, 결정 모델이 분류·검증하며, 사람이 예외를 책임지는 조합이 더 현실적인 다음 단계입니다.
기사가 마음에 드셨다면 하트를 눌러주세요.
기사 읽고, 잠깐 게임 한 판 어떠세요?
플레이 실력에 맞춰 난이도가 달라지는 15×15 오목
미니게임 고르기 ▶