Volantis, 8,800만달러 조달…레이저로 GPU 주변 메모리 220개 연결
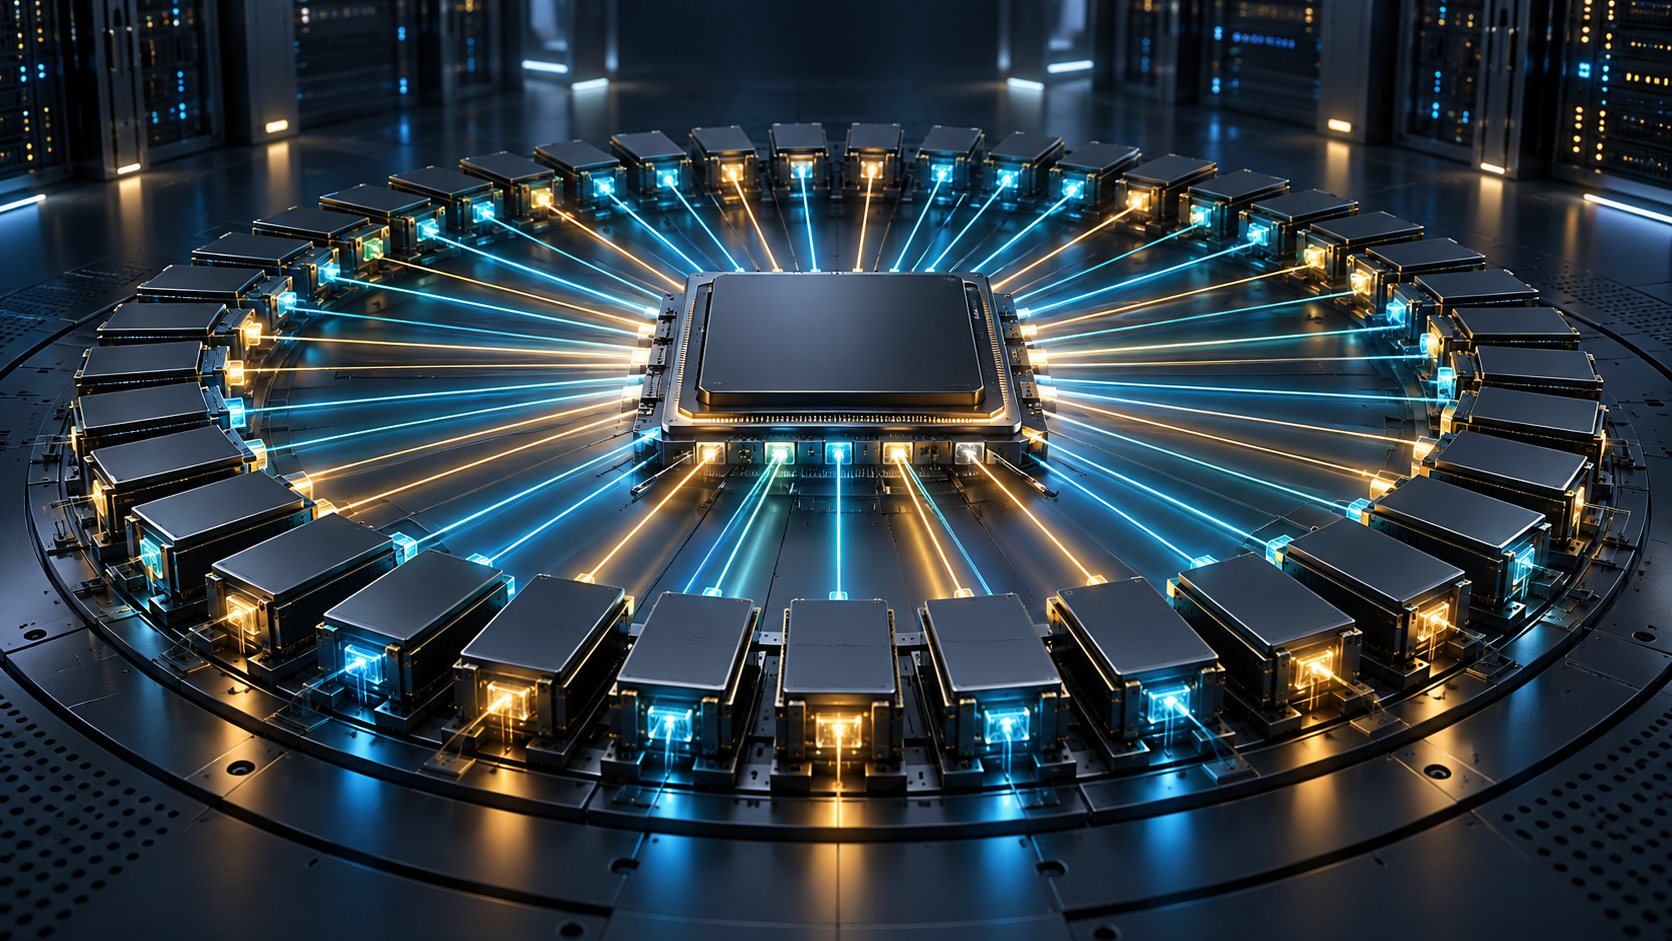
반도체 스타트업 Volantis가 8,800만달러 규모 시리즈A를 유치하고, 구리 배선 대신 VCSEL 레이저로 GPU와 메모리를 잇는 AI 추론 시스템 ‘A-1’을 공개했습니다. 회사는 GPU 하나 주위에 메모리 칩 최대 220개를 연결해 20조 파라미터가 넘는 모델을 사용자당 초당 최대 1만 토큰으로 처리하는 것을 목표로 합니다. 다만 이는 2027년 출시를 겨냥한 설계 목표이며, 실제 칩과 독립 벤치마크는 아직 나오지 않았습니다.
AI의 다음 병목은 연산보다 메모리 이동
대형 AI 모델의 가중치와 추론 중간값은 메모리에 머물고, GPU는 이를 끊임없이 불러와 계산합니다. 연산기가 빨라져도 데이터가 제때 도착하지 않으면 비싼 GPU가 기다리게 됩니다. NVIDIA와 AMD가 고대역폭메모리(HBM)를 가속기 바로 옆에 두는 이유이지만, 전기 배선은 거리가 길어질수록 신호 손실과 전력 부담이 커져 연결할 수 있는 메모리 수를 제한합니다.
Reuters에 따르면 Volantis는 현재 최고급 GPU 한 개에 붙는 HBM 패키지가 대체로 8개 수준인 구조를 문제로 봤습니다. 회사의 해법은 구리선 대신 빛으로 데이터를 옮겨 연결 거리를 넓히는 것입니다. 칩 하나의 연산량을 더 키우기보다 GPU가 훨씬 큰 메모리 풀을 빠르게 읽게 해 ‘메모리 벽’을 낮추겠다는 접근입니다.
아이폰 얼굴인식에 쓰인 VCSEL을 데이터센터로
핵심 부품은 수직공진표면발광레이저(VCSEL)입니다. 칩 표면에서 수직으로 빛을 내는 작은 레이저로, 스마트폰 얼굴인식과 거리 측정 장치에서 이미 대량 생산돼 왔습니다. Volantis는 익숙한 광원과 반도체 패키징 기술을 조합하면 완전히 새로운 부품 생태계를 만드는 위험을 줄일 수 있다고 설명합니다.
회사는 광링크의 도달거리 덕분에 GPU 하나 주위에 메모리 칩을 최대 220개까지 배치할 수 있다고 주장합니다. 용량이 늘면 거대한 모델을 여러 가속기에 잘게 나누는 통신 부담을 줄일 수 있습니다. 그러나 패키지 면적, 광원 수명, 열 방출, 오류 정정과 메모리 접근 일관성까지 해결해야 하므로 ‘빛을 쓴다’는 사실만으로 시스템 성능이 자동으로 따라오지는 않습니다.
A-1의 목표는 20조 파라미터와 초당 1만 토큰
첫 시스템 A-1은 20조 파라미터가 넘는 모델을 사용자당 초당 최대 1만 토큰으로 실행하는 것을 목표로 합니다. 긴 코딩 작업이나 다단계 에이전트처럼 응답 시간이 생산성에 직접 연결되는 추론을 겨냥했습니다. 회사는 메모리 용량과 대역폭 사이의 기존 절충을 없애 토큰당 비용도 낮추겠다고 밝혔습니다.
여기서 중요한 단어는 ‘목표’입니다. 수치는 완성 칩의 공개 벤치마크가 아니라 회사가 발표한 설계 사양입니다. 모델 정밀도, 배치 크기, 문맥 길이, 네트워크와 냉각 조건에 따라 토큰 속도와 비용은 크게 달라집니다. 2027년 제품이 나오기 전까지 기존 GPU 클러스터와 같은 조건에서 비교한 결과는 확인할 수 없습니다.
8,800만달러가 사는 것은 검증 시간
시리즈A는 Stripe 출신 투자자 Lachy Groom과 Abstract Ventures가 공동 주도했고 John Doerr, VXI Capital, Triatomic, Susa Ventures 등이 참여했습니다. 창업팀에는 NVIDIA, AMD, Broadcom, Ayar Labs 출신 인력이 포함됐으며, CoWoS 초기 제품과 가변 VCSEL, 공동 패키지 광학 시스템 개발 경험을 내세웠습니다.
조달금은 광칩 하나를 만드는 데만 쓰이지 않습니다. 실리콘 설계, 광소자 패키징, 메모리 인터페이스, 펌웨어, 냉각과 신뢰성 검증을 동시에 진행해야 합니다. 특히 데이터센터 고객은 몇 달의 데모가 아니라 수년간 고장률과 공급 가능성을 봅니다. 이미 성숙한 VCSEL 공급망을 활용한다 해도 220개 메모리를 하나의 사용 가능한 시스템으로 묶는 통합 난도가 핵심입니다.
봐야 할 것은 화려한 최대치보다 실제 경제성
Volantis의 발표는 HBM 적층만으로 메모리 병목을 풀기 어려워지면서 광연결이 칩 내부와 랙 사이의 경계를 넘나드는 흐름을 보여 줍니다. 성공하면 모델을 여러 GPU에 나누며 생기는 통신 비용을 줄이고, 더 큰 모델을 한 추론 도메인에 유지할 수 있습니다. 반대로 광원과 변환 회로의 전력이 커지면 얻는 이점이 상쇄될 수 있습니다.
2027년에 확인할 지표는 실제 연결 메모리 수, 유효 대역폭과 지연시간, 토큰당 전력·비용, 패키지 수율, 광원 교체와 장애 격리 방식입니다. 기존 HBM·CXL 메모리 확장과 비교한 독립 벤치마크도 필요합니다. 8,800만달러 조달은 기술이 입증됐다는 결론이 아니라, 이 질문들에 답할 시제품과 고객 검증을 끝낼 자원을 확보했다는 의미입니다.
기사가 마음에 드셨다면 하트를 눌러주세요.
기사 읽고, 잠깐 게임 한 판 어떠세요?
부드러운 이동과 통쾌한 잡기 연출을 담은 AI 장기
미니게임 고르기 ▶